40× rychlejší termodynamické simulace s CUDA GPU akcelerací
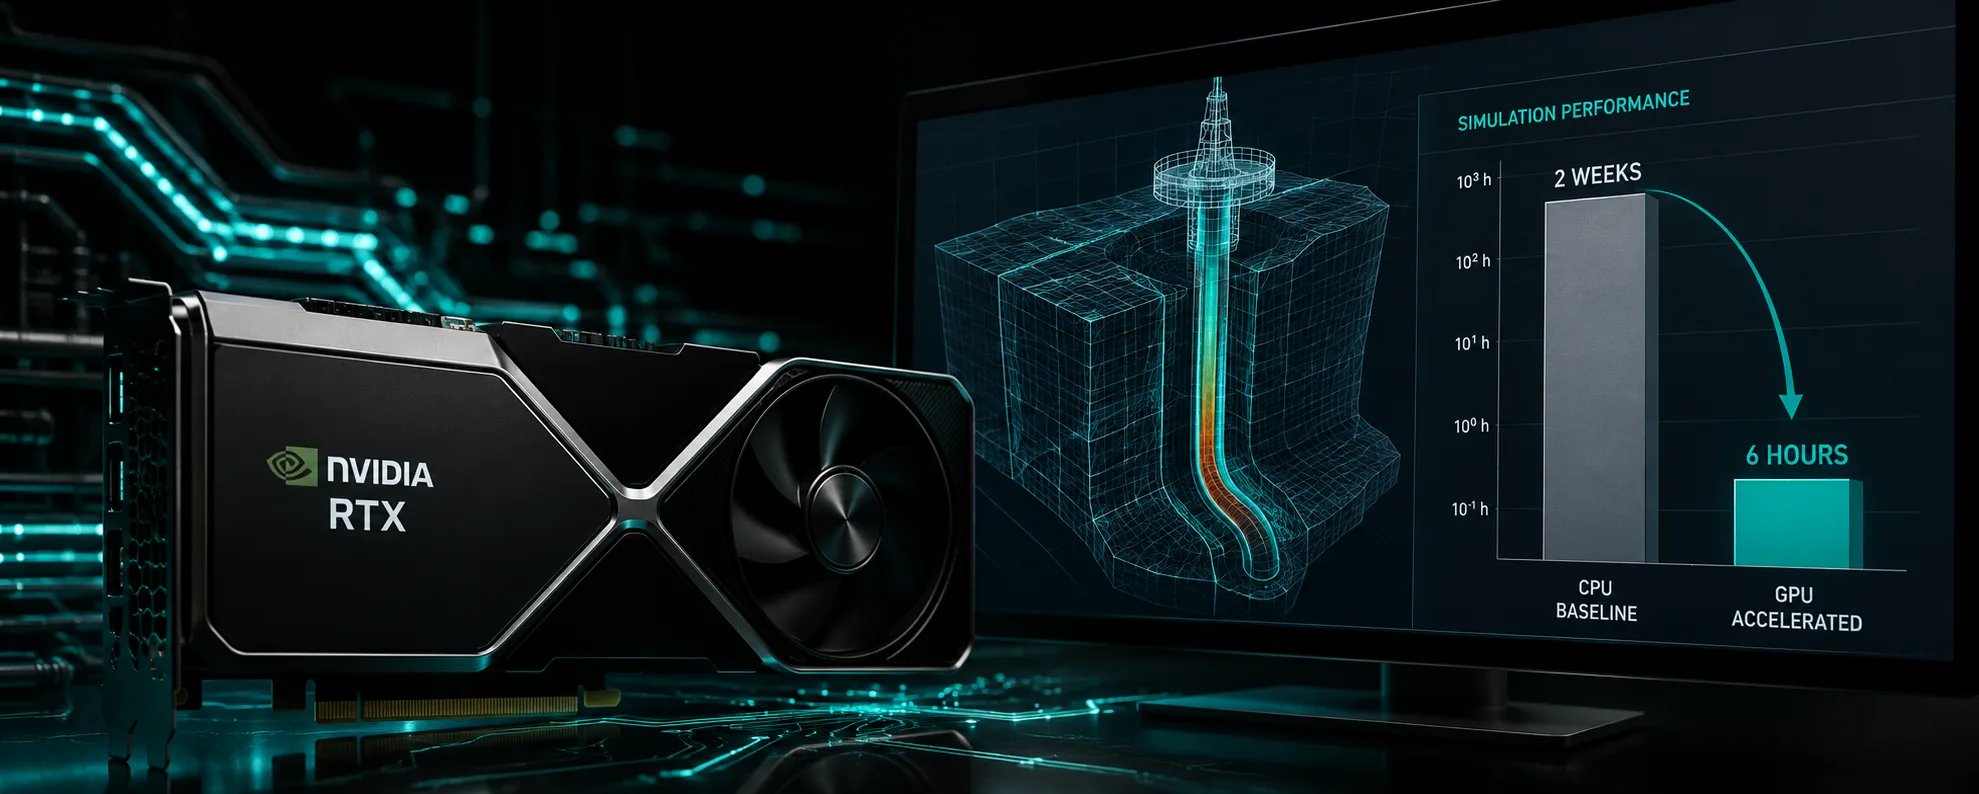
Ve spolupráci s průmyslovým partnerem v oblasti vrtání a předním univerzitním pracovištěm jsme provedli kompletní výpočetní transformaci CPU termodynamické simulace vrtání, migrovali jsme ji na masivně paralelní GPU exekuci pomocí NVIDIA CUDA. Co kdysi trvalo dva týdny, se nyní dokončí za šest hodin a umožňuje rychlou iteraci, real-time validaci a kratší inovační cykly.
Kategorie:
AI / MLOdvětví:
Energy / HPCKlient:
Industry & University PartnerRok:
2024Výzva
Průmyslové termodynamické simulace vrtání vyžadovaly enormní výpočetní zdroje. CPU architektury kladly tvrdé limity na paralelismus: rozsáhlé modely vyžadovaly až dva týdny na běh, pomalé zpětnovazební smyčky brzdily inženýrské inovace a vysoké náklady na energii dělaly časté experimentování nepraktickým. Klient potřeboval řešení, které zachová přesnost simulace a zároveň přinese řádové snížení doby běhu.
Naše řešení
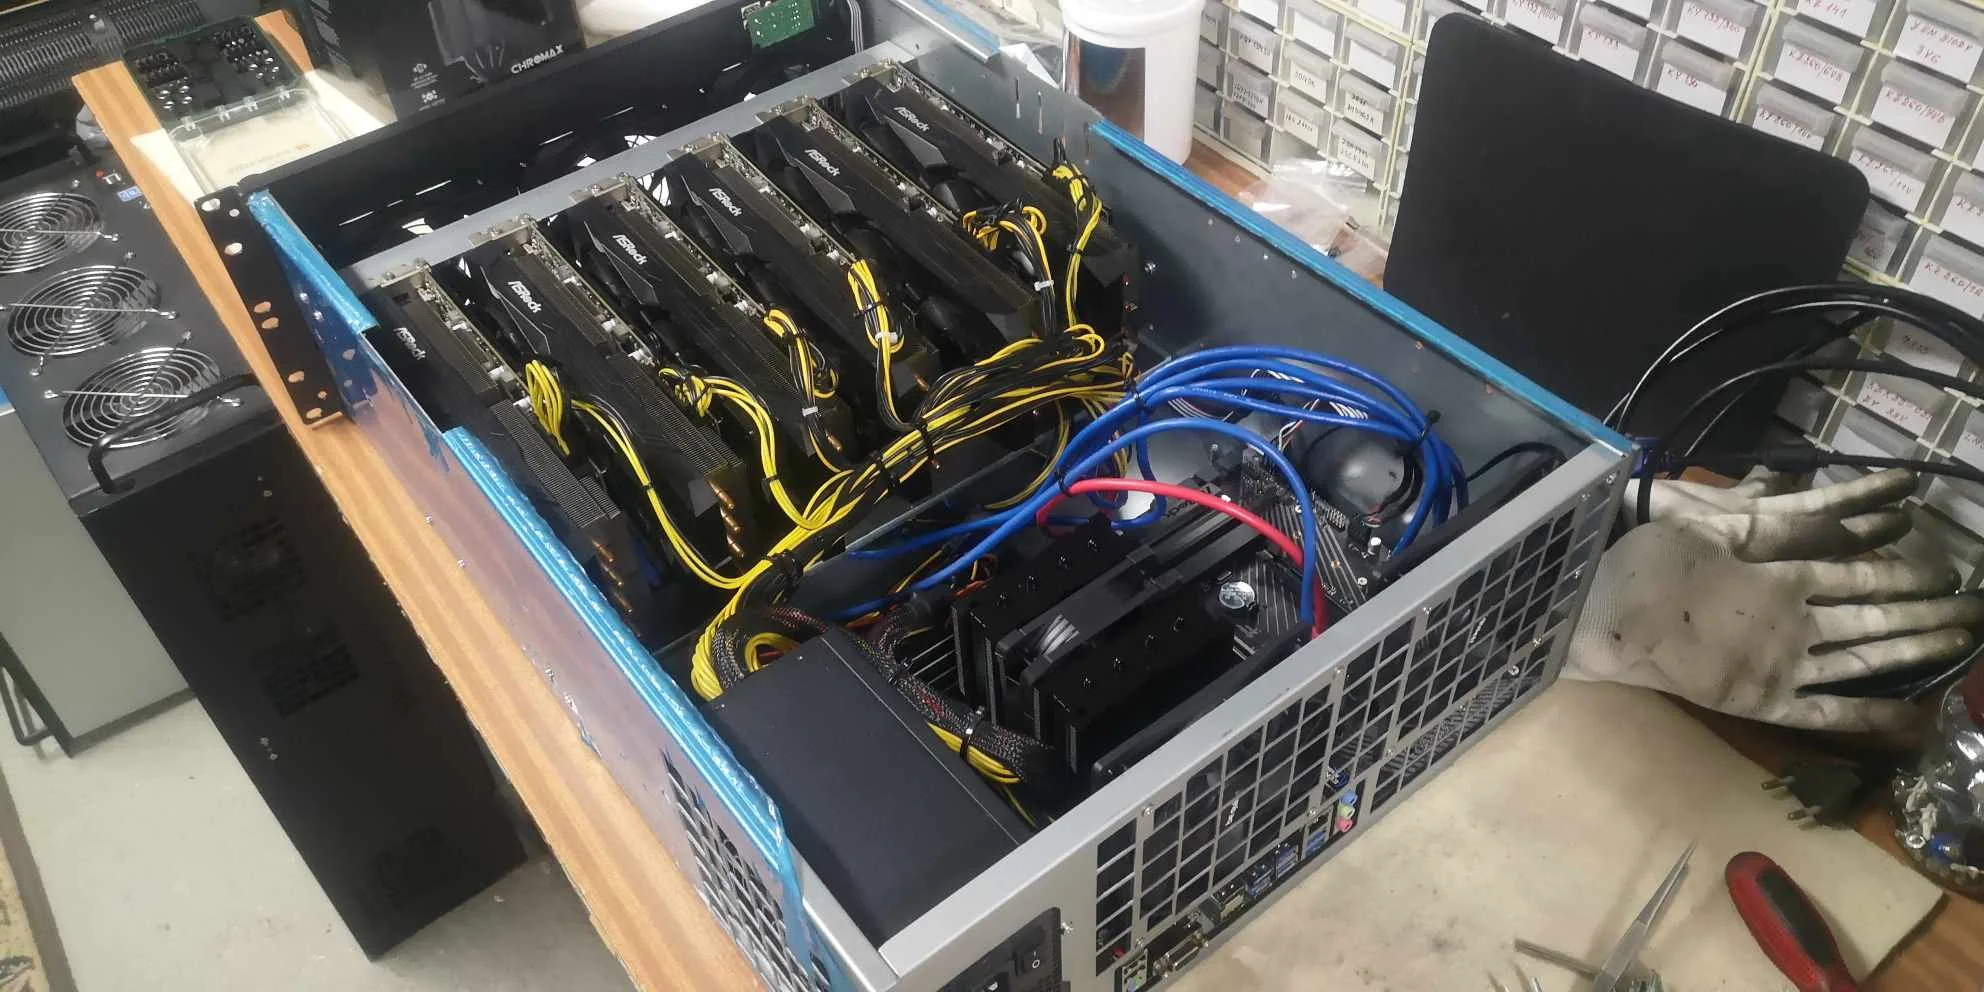
Přenesli jsme celý simulační framework z CPU na GPU pomocí NVIDIA CUDA a algoritmy jsme od základu restrukturalizovali pro masivně paralelní exekuci. Byly nasazeny dvě vyhrazené vysokovýkonné pracovní stanice: jedna vybavená NVIDIA RTX 4080 GPU a druhá s pěti GPU NVIDIA RTX 3070. Simulační kernely byly přepsány a optimalizovány pro GPU architekturu, paměťový management byl přepracován pro multi-GPU škálování a load balancing byl implementován napříč GPU clusterem. Výkon byl validován na reálných průmyslových datasetech v partnerství s průmyslovým klientem i univerzitním výzkumným týmem.
Klíčové funkce
- 40× zrychlení výpočtu: Doba běhu snížena ze 14 dní na pouhých 6 hodin: transformace, která zásadně změnila inženýrský workflow.
- Architektura multi-GPU clusteru: Nasazeno přes dvě pracovní stanice (RTX 4080 + 5× RTX 3070) s load balancingem a multi-GPU škálováním.
- Optimalizace CUDA kernelů: Simulační kernely restrukturalizovány pro paralelní tepelné a tokové výpočty při zachování plné numerické přesnosti.
- Přepracovaný paměťový management: GPU paměťová hierarchie optimalizována pro efektivní zpracování velkých simulačních datasetů napříč více zařízeními.
- Validace průmysl–akademie: Výsledky společně validovány s průmyslovým i univerzitním partnerem, což zajišťuje vědeckou přísnost a reálnou aplikovatelnost.
- Zisky v energetické účinnosti: Významné snížení spotřeby energie a provozních nákladů na jeden simulační běh.
Technologie
- NVIDIA CUDA
- C++
- Python
- RTX 4080
- RTX 3070
- HPC
- Multi-GPU
- Parallel Computing
Výsledky
Tento projekt prokazuje, že GPU paralelizace dokáže nově definovat hranice inženýrských simulací. 40× zrychlení odemklo cykly rychlého experimentování a validace, které byly dříve nemožné, a poskytlo klientovi rozhodnou konkurenční výhodu v simulaci vrtání a vývoji modelů.
Pojďme spolupracovat
Hledáte technického partnera pro váš projekt?
Specializujeme se na firmware, edge AI a průmyslovou vizuální inspekci. Projdeme si spolu váš projekt a navrhneme konkrétní řešení na míru.
